用 Coding Agent 做一个随机动物抽选器
从数据结构到可访问页面,规划随机动物抽选器、无重复抽取和边界验收,完成一个范围明确的 Coding Agent 入门项目。
本页内容
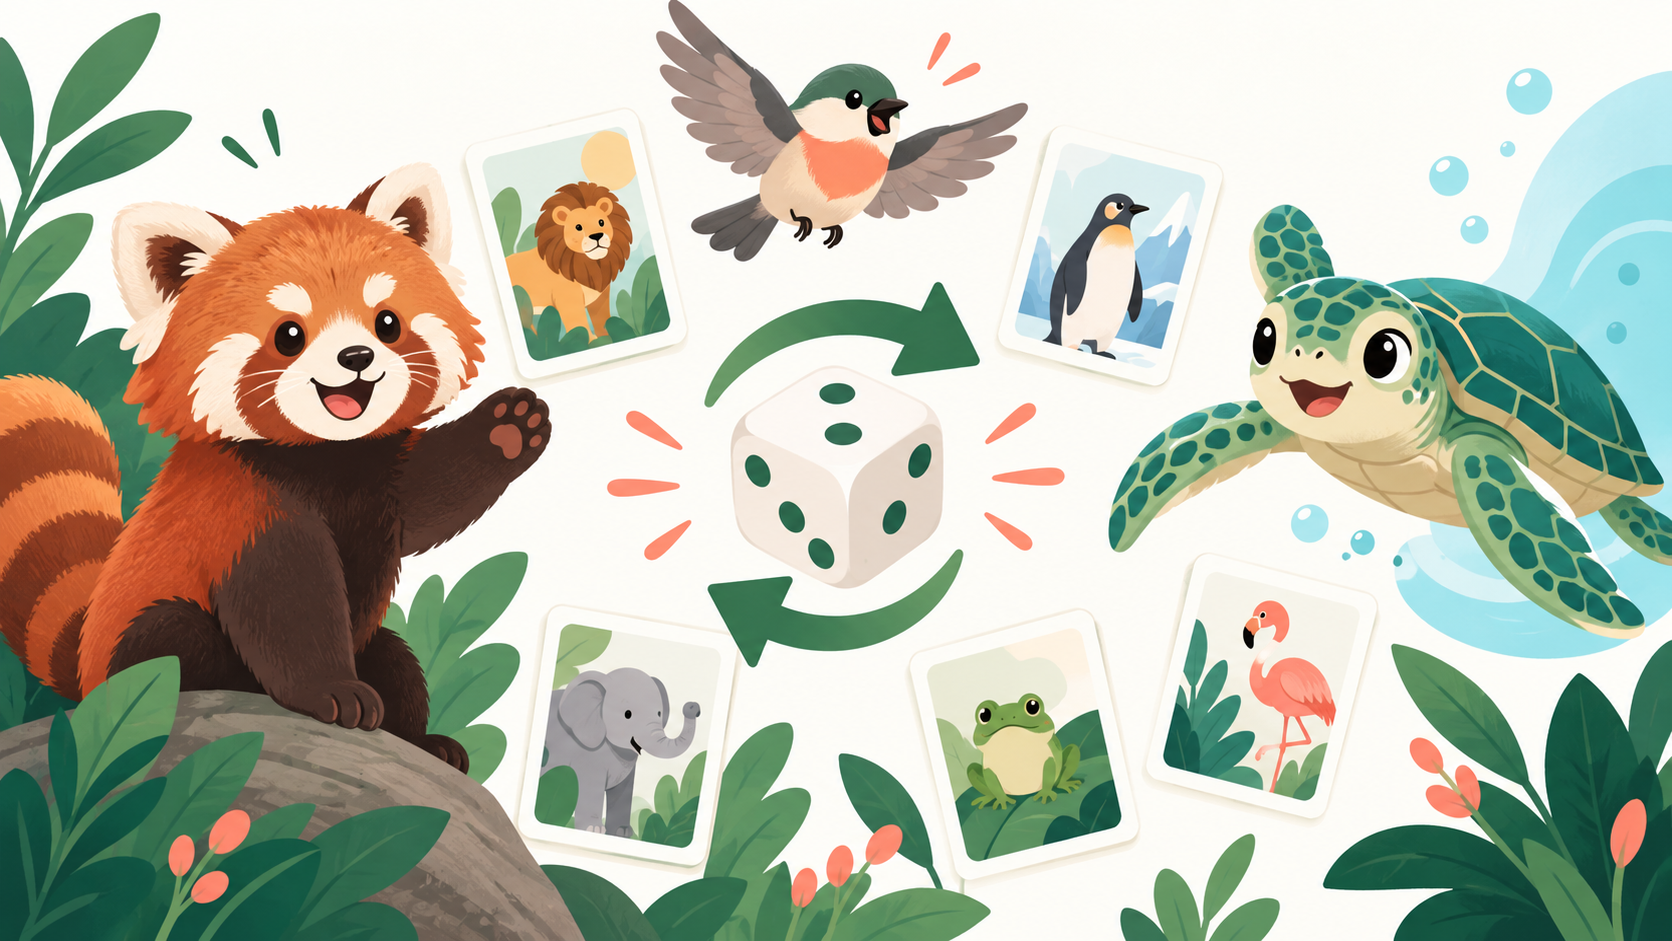
随机动物抽选器适合作为第一个 Coding Agent 项目,因为结果看得见,规则也容易检查。先用一份小型本地动物列表,再逐步增加筛选、批量抽取和无重复轮次。
为什么随机动物抽选器适合作为入门项目
核心行为一句话就能说明:从列表中选出一种动物并展示结果。这给编码 Agent 一个清楚的目标,也让你能通过界面检查结果,例如再次抽取、筛选列表,以及显示名称或图片。
第一版保持简单。用一小份本地数据,记录 id、常见名称、类别和可选的图片路径。只有在能保留来源并核对文字时,再补充动物知识。
先写清随机动物抽选规则,再做界面
在让 Agent 制作控件前,先决定什么样的抽取结果才有效。这些规则可以提前处理常见边界情况:
- 动物池包含哪些记录?类别筛选怎样缩小范围?
- 每轮抽一个还是一批?批量上限是多少?
- 本轮是否允许重复?不允许时,什么时候重置动物池?
- 筛选条件没有匹配项时,页面显示什么?
- 结果旁要显示哪些资料和图片署名?
筛选应直接作用于抽取用的候选列表,不能等抽出不合条件的结果后再把它藏起来。无重复抽取时按 id 记录已使用项目,不要只比较展示名称;不同记录可能有相同或相近的名称。
分开实现随机抽取和无重复抽取
基础抽选器可以从筛选后的列表中选一个有效下标。读取项目之前先处理空列表。对于课堂活动或创意提示,这种普通伪随机抽取通常够用;它不适用于安全决策或需要审计的奖金抽取。
function pickOne(pool) {
  if (pool.length === 0) return null;
  const index = Math.floor(Math.random() * pool.length);
  return pool[index];
}需要批量无重复抽取时,先复制筛选后的动物池,再用 Fisher–Yates 算法打乱,最后取所需数量。需要在一轮中连续抽取时,每次从剩余池移除已抽到的 id;只有用户重置本轮时才重新填充。
抽取时不要修改原始数据。保留不变的来源数据后,类别切换、重置和自动检查都会更容易理解。
给编码 Agent 一个范围明确的实现任务
先让 Agent 实现一条完整可用的路径,再补充细节。在 DSH 工作区中,可以先沿用仓库现有结构,只修改抽选器相关页面,并在 Review 时检查 diff。
基于这份本地数据制作响应式随机动物抽选器。
支持抽取一个结果、按类别筛选和本轮无重复。
处理筛选结果为空和只有一条记录的情况。
为抽取、重置和防重复增加针对性测试。
不要新增依赖,也不要加载外部图片。
列出改动文件和测试结果。把任务控制在容易 Review 的范围内。基本流程通过后,再单独增加批量数量控件或动物资料页。这样新增控件改变抽取逻辑时,更容易定位问题。
用边界情况验收随机动物抽选器
先逐项测试规则,再到浏览器里操作页面控件。一个简单清单能发现首次抽取成功时看不出来的问题:
- 源列表为空或筛选无匹配项时,页面能显示明确的空状态。
- 动物池只有一条记录时,不会产生无效下标或卡住无重复轮次。
- 批量抽取数量不会超过当前剩余记录数。
- 重置会恢复符合条件的动物集合,且不会修改源数据。
- 键盘焦点、触控区域、图片署名和窄屏布局都能正常使用。
Random Animal Picker 当前提供类别筛选、批量抽取、可选的本轮无重复,以及包含可用资料和来源的结果页。可以用它理解交互方式;使用其中的照片或内容前,仍要核对许可和署名要求。
随机动物抽选器项目常见问题
最简单的第一版应该做什么?
用一小份本地列表、一个抽取按钮和一张显示名称与类别的结果卡片。基本路径可用后,再增加筛选或批量抽取。
无重复轮次应该如何实现?
记录已抽取项目的 id,或使用单独的剩余动物池。用户开始新一轮时再重置动物池。
随机动物抽选器可以用于抽奖吗?
使用普通浏览器伪随机数的休闲抽选器,不应被当作安全或可审计的抽奖系统。重要抽取应使用专门且可验证的流程。
结论
随机动物抽选器是一个适合入门的 Coding Agent 项目,前提是先说清数据、抽取规则和边界情况。先做最小可用版本,验收无重复和重置逻辑,再分步扩展界面。